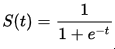Character Recognizer
Acquisition des connaissances
Avant de commencer la recherche, nous avions une idée de base à propos des réseaux de neurones. Ce sujet est évidemment l'enjeu principal de la recherche et une description sommaire est offerte dans cette section.
1. Réseaux de neurones
1.1. Structure d'un réseau
Le diagramme le plus commun en ce qui a trait aux réseaux de neurones est le suivant:
Ce qui est important à retenir à propos des réseaux de neurones est qu'il s'agit de fonctions universelles, c'est-à-dire qu'avec les bons paramètres et la bonne structure, un réseau peut émuler n'importe quelle fonction, même si cette fonction peut sembler abstraite. Par exemple, la fonction émulée par nos réseaux est celle qui prend comme entrée une série de zéros et de uns représentant un caractère, et qui donne une suggestion du caractère le plus probable.
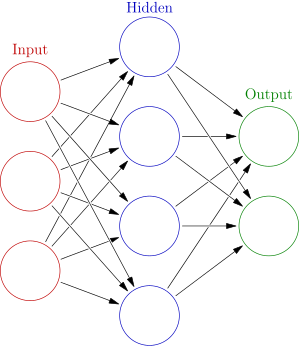
Chaque entrée (input) représente un nombre entre -1 et 1 (ou dans certains cas, 0 et 1). Chacun des «neurones» est relié avec tous les autres neurones de la couche suivante. Dans le diagramme ci-dessus, il y a une seule couche cachée (hidden layer) mais il peut y en avoir autant que nécessaire. Dans le cadre de l'application développée dans la recherche, une seule couche cachée est utilisée dans les réseaux.
Ensuite, suivant le même principe, chaque neurone de la couche cachée est relié avec tous les neurones de la couche suivante, la couche de la sortie (output layer)
1.2. Les poids
Tout le pouvoir d'un réseau de neurone est contenu dans les poids (weights) attachés aux connexions entre les neurones. Il s'agit d'un nombre qui multiplie la valeur contenu dans le neurones.
Lorsqu'un neurone reçoit les valeurs des neurones de la couche précédentes, celles-ci sont multipliées par chacun des poids. Ensuite, le résultat de toutes ces multiplications sont additionnées ensemble pour arriver à la valeur du neurone. En général, une fonction mathématique (voir annexe 1) est également utilisée pour transformer la somme en nombre entre -1 et 1.
2. Entraînement d'un réseau
2.1. Concept
Pour entraîner un réseau de neurone, il faut d'abord lui dire quelles entrées de valeurs sont censées donner quelles sorties de valeur. Lors de l'algorithme d'entraînement, le réseau ajustera les poids du réseaux afin d'arriver à des valeurs la plus près du but.
2.2. Fonction de coût
La fonction de coût (cost function) représente le taux d'erreur entre ce qui est attendu du réseau et ce que le réseau donne.
En général, cette fonction est calculée en prenant chaque échantillon et en évaluant ce que le réseau donne comme résultat. On prend ensuite le carré différence entre cette valeur et le but attendu (on met cette valeur au carré pour avoir uniquement un nombre positif). Ce processus est répété pour chaque échantillon et les différences sont additionnées.
Une fois la fonction de coût calculée, il est possible d'entraîner le réseau. Peu importe l'algorithme utilisé, son but sera de minimisée cette fonction pour arriver à un résultat le plus près possible de zéro, puisqu'une valeur d'exactement zéro signifie que le réseau ne s'est aucunement trompé.
2.3. Descente du gradient
L'algorithme utilisée dans le cadre de ce travail, nommé Backpropagation est un cas particulier qui utilise la descente du gradient.
La descente du gradient permet simplement d'indiquer de combien on doit ajuster chacun des poids du réseau afin d'arriver à minimiser la fonction de coût. Intuivement, on peut s'imaginer sur une montagne. Même si on ne voit ni le haut ni le bas de la montagne, on peut juger immédiatement vers quelle direction le haut se situe d'après la pente à nos pieds.
D'un côté plus mathématique, la descente du gradient calcule la dérivée de la fonction de coût par rapport à chaque poids. C'est une opération relativement coûteuse en terme de mémoire (surtout sur des réseaux avec beaucoup de neurones), mais le résultat en vaut la peine: Une fois calculé, le gradient indique dans «quelle direction» il faut se déplacer pour minimiser le taux d'erreur du réseau. Il suffit ensuite de répéter ce processus pour diminuer le taux d'erreur autant que possible.
2.4. Limitation
Il arrive à cet algorithme de bloquer lorsqu'il arrive dans un minimum local, c'est-à-dire que peu importe dans quelle direction il déplace les poids du réseau, le taux d'erreur augmente. L'entraînement du réseau s'arrêtera donc, même si le réseau n'est pas complètement entraîné. Il existe plusieurs techniques pour remédier à ce problèmes, mais elles vont à l'extérieur du cadre du projet de recherche.
Annexe
A1. Fonctions de transfert
Une fonction de transfert est une fonction qui permet de transformer la somme des valeurs des neurones entrants afin d'arriver à une valeur appropriée avant de la transférer en tant que valeur extrant
La fonction de transfert la plus populaire, ainsi que celle utilisée dans la recherche, est la fonction sigmoïde: