Character Recognizer
Analyse des résultats
Avec les résultats obtenus, nous avons pu voir que les hypothèses de départ avaient été confirmées pour la plupart. Par exemple, l’application a bel et bien de la difficulté à distinguer les caractères qui se ressemblent (exemple : « O » et « 0 », « 1 » et « I », etc.)
Pendant l’expérimentation, il est arrivé quelques fois que l’application confondent des caractères qui sont pourtant peu similaires (« K » et « M » par exemple) et nous avons fini par remédier à ce problème en séparant ces caractères dans des réseaux de neurones différents.
Il serait donc possible de rajouter des réseaux de neurones encore plus petits pour permettre à l’application de distinguer les « O » des « 0 », mais une telle solution requiérerait plus de temps d’apprentissage et davantage d’échantillons. Nous avons donc dû faire des compromis dans l’infrastructure des réseaux pour arriver aux résultats que nous avons eus.
De cette façon, nous considérons les résultats satisfaisants lorsque la plupart des caractères présentés à l’applications font partie des 3 premières prédictions des réseaux de neurones. Nous avons également des graphiques qui nous ont permis de juger en un coup d’œil l’efficacité des réseaux :
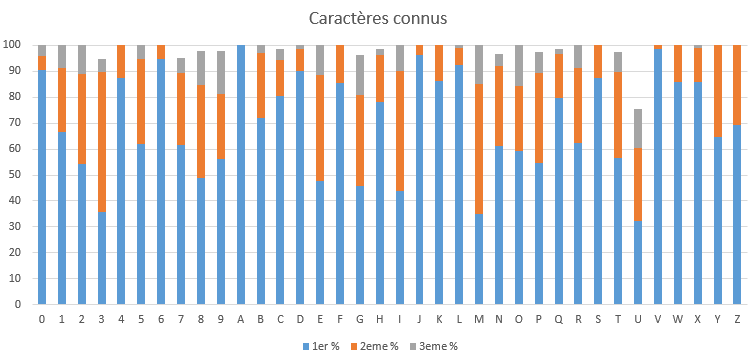
À mesure que nous avons entraîné les réseaux avec les différentes techniques mentionnées dans la section «Démarche», ce graphique a évolué pour finalement arriver à des résultats satisfaisants.